XSS: Ataques Armazenados, Refletidos e Baseados em DOM — e Por Que mark_safe e Markdown Inseguro São Igualmente Perigosos
Django Security Series — Post 2 | Série I: Ataques de Injeção
OWASP A05:2025 — Injection | Tempo de leitura: ~20 min
🧪 Rode você mesmo. Este ataque vem como um laboratório executável no django-security-lab: um quadro de comentários vulnerável que marca o HTML enviado pelo usuário como seguro sem nenhum sanitizador, e um seguro que o passa antes pelo
nh3. Tudo é exercitado pela linha de comando — publique um payload comcurle depois leia-o de volta ao vivo no quadro vulnerável e removido no seguro. Clone o repositório e reproduza cada passo.
O Post 1 desta série abordou SQL Injection — um ataque que tem como alvo o banco de dados ao quebrar a barreira entre a estrutura SQL e os dados. O Post 2 sobe na pilha para a camada do navegador: Cross-Site Scripting (XSS), onde a barreira que está sendo quebrada é entre a estrutura HTML e o conteúdo fornecido pelo usuário. Os dois ataques compartilham a mesma causa raiz — tratar entrada não confiável como código confiável — e os dois são agrupados sob OWASP A05:2025 Injection por isso.
Este post existe por causa de uma decisão real que precisei tomar. O Petição Brasil — minha plataforma civic-tech para petições com validade jurídica — renderiza descrições de petições enviadas pelos usuários como Markdown. Isso significa que existe uma chamada mark_safe() em algum ponto do pipeline, e a única coisa entre a tag <script> de um atacante e execução total no navegador de cada visitante é a sanitização que acontece antes dessa chamada. Quando descobri que o bleach — a biblioteca na qual eu confiava para essa sanitização — havia sido colocado em modo de manutenção mínima pela Mozilla em janeiro de 2023, precisei entender exatamente qual era sua falha e com o que substituí-lo. Essa pesquisa se tornou este post.
O mecanismo de templates do Django faz escape automático de HTML por padrão, o que bloqueia a maior parte dos ataques XSS sem que você perceba. Este post trata de onde essa proteção termina: as saídas que a desligam, o pipeline de Markdown que faz parecer necessário usar uma delas e a troca do bleach pelo nh3, um binding Python para o sanitizador Ammonia, escrito em Rust.
O Ataque: O Que É e Como Funciona
Cross-Site Scripting ocorre quando uma aplicação inclui dados não confiáveis em uma página web sem a codificação de saída adequada — permitindo que um atacante execute scripts no navegador de uma vítima no contexto da origem da aplicação. O navegador não consegue distinguir entre scripts que o desenvolvedor pretendia e scripts que o atacante injetou: ambos chegam no mesmo documento HTML, do mesmo domínio, com acesso aos mesmos cookies, DOM e armazenamento.
O nome 'Cross-Site Scripting' é basicamente um artefato histórico a esta altura. Na prática, significa apenas que um atacante encontrou uma forma de executar o próprio código dentro dos navegadores dos seus usuários. Um ataque XSS bem-sucedido dá ao atacante o mesmo acesso ao DOM que o seu próprio JavaScript tem: ele pode ler qualquer cookie que não seja HttpOnly, capturar teclas digitadas, fazer requisições autenticadas à API em nome da vítima, redirecionar para uma página de phishing ou minerar criptomoeda em segundo plano.
O XSS Armazenado é o pior cenário: o payload é escrito no armazenamento de dados da aplicação — um comentário, uma bio de perfil, uma avaliação de produto, um post em fórum — e a partir desse momento, ele é executado no navegador de cada visitante sem nenhuma ação adicional do atacante. Uma única submissão, vítimas ilimitadas. O atacante não precisa continuar enviando links de phishing ou enganando usuários para clicarem em nada; ele simplesmente aguarda enquanto a aplicação faz o trabalho por ele.
A parte forense também é preocupante. O conteúdo malicioso é servido pela própria origem da aplicação via respostas HTTP normais, então os logs do servidor simplesmente mostram carregamentos de página comuns. O navegador da vítima não tem razão para emitir alarmes — o script vem de um domínio confiável. O padrão SESSION_COOKIE_HTTPONLY = True do Django torna o cookie de sessão ilegível a partir do JavaScript — ele simplesmente não aparece na API document.cookie — fechando o caminho mais óbvio de exfiltração. Mas o XSS ainda pode ler tokens CSRF do DOM, executar ações autenticadas dentro da página usando a sessão existente, registrar teclas digitadas ou reescrever a UI, então o HttpOnly é uma mitigação parcial, não uma correção.
Exemplo concreto: um campo de comentário que armazena e renderiza a entrada do usuário sem sanitização. Um atacante envia um corpo de comentário que, a cada carregamento de página, lê o token CSRF do DOM e o usa para realizar uma ação autenticada contra a própria API da aplicação em nome do visitante — por exemplo, postando outro comentário, alterando o e-mail do visitante ou seguindo uma conta controlada pelo atacante:
<script>
fetch('/api/account/email/', {
  method: 'POST',
  credentials: 'include',
  headers: {'X-CSRFToken': document.querySelector('[name=csrfmiddlewaretoken]').value},
  body: new URLSearchParams({email: 'attacker@example.com'})
});
</script>
O comentário é salvo no banco de dados. Todo visitante subsequente que carregar a página executa silenciosamente essa requisição do próprio navegador, com o próprio cookie de sessão, contra o site legítimo — ele não vê nada de incomum. O atacante submeteu o payload uma vez; cada carregamento futuro da página é uma reexecução automática. (O payload canônico de exfiltração de document.cookie ainda aparece em demos e materiais antigos, mas em uma aplicação Django moderna com configuração padrão ele não retornaria o cookie de sessão por causa do HttpOnly; ele ainda pode vazar quaisquer outros cookies não-HttpOnly que o site definir.)
Atributos HTML fornecem pontos de injeção alternativos quando tags <script> são removidas mas manipuladores de eventos não são: <img src=x onerror=...>, <svg onload=...>, <body onpageshow=...>. Em Markdown especificamente, os alvos de links são um vetor crítico: [clique aqui](javascript:alert(document.cookie)) renderiza como <a href="javascript:alert(document.cookie)">clique aqui</a> — Markdown válido, XSS válido, e um link que um sanitizador com allowlist precisa rejeitar pelo esquema, que é o que o bleach e o nh3 fazem por padrão e o que um mark_safe() sem sanitização não faz.
A mesma falha chega ao navegador por outros dois caminhos. No XSS refletido, o payload viaja numa URL ou num envio de formulário e a resposta o ecoa de volta, sem armazenar nada: é o mesmo defeito, mas cada vítima precisa ser atraída para um link criado pelo atacante. No XSS baseado em DOM, a resposta do servidor está limpa: o próprio JavaScript da página lê uma fonte controlada pelo atacante, como location.hash, e a escreve num sink como innerHTML, então o payload pode ficar num fragmento de URL que o Django nunca recebe, e a correção fica no JavaScript (textContent, um sanitizador, a diretiva CSP Trusted Types). E o escape só serve ao contexto para o qual foi feito: um valor dentro de um bloco <script> precisa de codificação JSON (json_script), um atributo sem aspas aceita um event handler, e o href de um link executa javascript: a menos que o esquema seja conferido.
Incidentes Reais
O Worm XSS do TweetDeck (2014)
Em junho de 2014, um adolescente austríaco que se apresenta online como Firo estava experimentando com o TweetDeck — o painel oficial do Twitter para usuários avançados — tentando fazer o serviço exibir o caractere unicode ♥. Ele descobriu que o TweetDeck tratava como HTML qualquer coisa num tweet que terminasse com o coração e mostrou isso publicamente, com um popup alert() inofensivo. Avisou o Twitter catorze minutos depois, mas a falha já estava circulando. Noventa minutos mais tarde, um estudante alemão de TI, @derGeruhn, a transformou num worm autorreplicante: um único tweet contendo um bloco <script> que se retuitava a partir da conta de cada usuário do TweetDeck que o carregasse. O Twitter tirou o TweetDeck do ar temporariamente e o reabriu depois de verificar uma correção; quando o Guardian publicou a matéria, o tweet do worm tinha 81.500 retuites.
O incidente do TweetDeck em 2014 é um exemplo real perfeito de como o XSS Armazenado pode sair do controle rapidamente — e um lembrete útil de que práticas de divulgação de vulnerabilidades importam tanto quanto o patch. A fórmula foi dolorosamente simples: um pipeline de renderização sem sanitizador de HTML, um campo de conteúdo gerado pelo usuário, e cada visitante subsequente executa o que foi armazenado. Em termos de ATT&CK, a execução de código se encaixa em T1059.007 (Intérprete de Comando e Script: JavaScript). O Twitter nunca publicou os detalhes da correção, mas o tipo de correção é uma única mudança nesse pipeline: sanitizar o conteúdo do tweet antes de inseri-lo no DOM — o passo que o nh3.clean() acrescenta entre markdown.markdown() e mark_safe() no pipeline seguro deste post. Para desenvolvedores Django o paralelo é direto: um campo de comentário, uma bio de usuário, uma avaliação de produto — qualquer campo que armazena conteúdo de um usuário e o exibe para outros se torna o ponto de entrada deste worm se chegar ao navegador sem sanitização.
Proteções Padrão do Django
O mecanismo de templates do Django faz escape automático de toda saída de variáveis por padrão. O escape automático é o processo de converter automaticamente os caracteres que têm significado especial em HTML nos seus equivalentes de texto seguro antes de serem escritos na página — assim, um valor como <script> é exibido como texto visível em vez de ser executado como markup. Quando você escreve {{ variavel }} em um template, o Django converte cinco caracteres antes de inserir o valor no HTML:
| Caractere | Escapado como |
|---|---|
< |
< |
> |
> |
' |
' |
" |
" |
& |
& |
(Nota de rodapé: o Django historicamente fazia escape de ' para a entidade decimal ' e mudou para a forma hexadecimal ' no Django 3.0. Ambas são referências HTML válidas para o mesmo caractere, então exemplos antigos ou sessões de shell podem mostrar qualquer uma das formas.)
Um payload armazenado de <script>alert(1)</script> em um campo de model renderiza como <script>alert(1)</script> — texto visível inofensivo no navegador, nunca interpretado como HTML. O auto-escaping é aplicado a toda expressão {{ variavel }} automaticamente, sem nenhuma ação do desenvolvedor.
O auto-escaping se aplica independentemente da origem do valor — um campo de model do banco de dados, um parâmetro de consulta de URL (request.GET), um envio de formulário (request.POST) ou qualquer outra fonte. A origem dos dados não faz diferença; o mecanismo de templates faz o escape de todo {{ variavel }} da mesma forma.
Essa proteção se aplica à etapa de codificação de saída — a transformação final antes de o HTML ser enviado ao navegador. Ela termina onde o desenvolvedor declara um valor seguro: mark_safe(), o filtro | safe e blocos {% autoescape off %} desativam o auto-escaping completamente para os valores que tocam. Esses casos são abordados na próxima seção.
O Padrão Vulnerável e a Correção
1. Marcar conteúdo do usuário como seguro
mark_safe() existe para HTML que o desenvolvedor construiu: um menu de navegação montado em Python, um widget que renderiza o próprio markup. É uma declaração ao Django: "Eu verifiquei que esta string é HTML seguro; renderize-a como markup, não como texto." Toda a garantia de segurança depende de essa declaração ser verdadeira, e o Django não a verifica. Faça essa declaração sobre um conteúdo que um usuário escreveu e ela passa a ser falsa.
O mural de comentários do laboratório comete esse erro, e a correção é a única chamada que o gêmeo seguro acrescenta:
     rows = "".join(
-        f"<li><strong>{escape(c.author)}</strong>: {as_html(mark_safe(c.body))}</li>"
+        f"<li><strong>{escape(c.author)}</strong>: {as_html(mark_safe(nh3.clean(c.body)))}</li>"
         for c in Comment.objects.order_by("id")
     )
as_html é o substituto de três linhas que o laboratório usa para o auto-escaping de template: ele faz escape de tudo que não foi marcado como seguro, o que faz do mark_safe() a decisão que importa, exatamente como seria num template. No mural vulnerável, um <img src=x onerror=...> armazenado volta como markup ativo, e o handler dele consegue ler o token de sessão da página. No seguro, o nh3.clean() já removeu o handler antes de qualquer coisa ser marcada como segura, e um <strong> legítimo continua sendo renderizado. As duas views estão completas no laboratório: views_vulnerable.py e views_secure.py.
A camada de template faz a mesma declaração de duas outras formas. {{ comment.body | safe }} é um mark_safe() sobre esse valor, e {% autoescape off %} faz a declaração para toda variável dentro do bloco, inclusive as que um desenvolvedor futuro acrescentar sem perceber que o bloco está ali. Nenhuma das duas se resolve com cuidado naquela linha: o valor precisa chegar ao template já sanitizado.
2. Markdown sem sanitizador
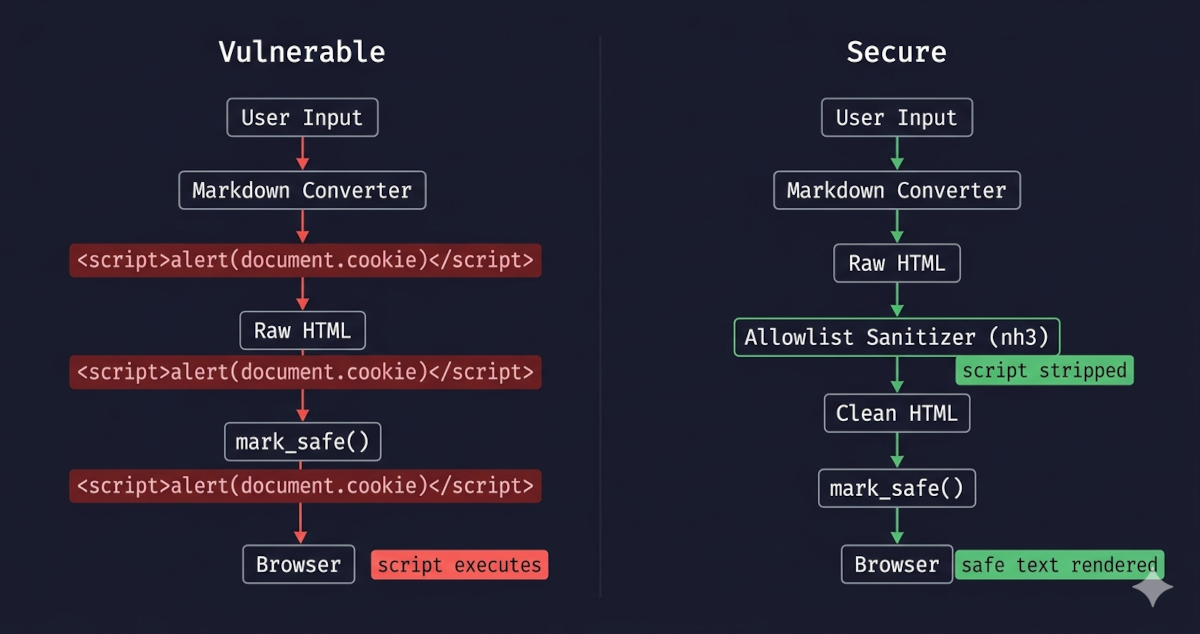
O Markdown passa a impressão de ser uma camada de separação entre o usuário e a página. Não é. A biblioteca Python markdown deliberadamente repassa para a saída o HTML bruto que encontra na entrada, então um usuário pode digitar um <script> literal num texto em Markdown. Quando a aplicação chama mark_safe() sobre o HTML convertido para que a formatação apareça, essa tag chega à página intacta. A correção é sanitizar entre os dois passos:
 def render_user_content(text):
     html = markdown.markdown(text)
-    return mark_safe(html)  # <script> em 'text' sobrevive à etapa de markdown
+    return mark_safe(nh3.clean(html))
A ordem é a correção inteira: converter, depois sanitizar, depois marcar como seguro. O mark_safe() não sanitiza nada; ele só avisa ao mecanismo de templates que não faça escape de uma string que outra etapa já tornou segura, e é por isso que precisa ser a última chamada e rodar sobre a saída do sanitizador. Os padrões do nh3 são uma allowlist que remove tags não permitidas, atributos de event handler e URLs javascript: ou data:, e você pode restringi-la passando tags= como um set e attributes= como um dict que mapeia cada tag para um set de atributos. Não existe flag no conversor que o torne seguro no lugar disso: desde a versão 3.0 (2018) a biblioteca ignora em silêncio a antiga opção safe_mode — passá-la não gera erro nem escapa nada —, e a documentação recomenda um sanitizador de HTML na etapa seguinte.
Se o sanitizador do seu pipeline é o bleach, ele está fazendo esse trabalho corretamente, e mesmo assim vale substituí-lo. A Mozilla descontinuou o bleach em 23/01/2023 porque ele se apoia no parser html5lib, que não tem uma versão nova desde 2020, e a partir dali prometeu apenas correções de segurança, suporte a novas versões do Python e correções de bugs graves. Essa promessa acabou: a versão 6.4.0, lançada em 05/06/2026, é a última, não haverá mais correções de nenhum tipo, nem mesmo de segurança, e o repositório foi arquivado. A falha que eu fui procurar, como contei na introdução, não existe. O bleach valida esquemas de URL exatamente como o nh3 — o ALLOWED_PROTOCOLS dele tem como padrão http, https e mailto —, então [clique aqui](javascript:alert(1)), convertido para HTML e passado por bleach.clean(), sai como <a>clique aqui</a>: o href é descartado, o texto é mantido. O motivo para sair não é uma falha que alguém conheça hoje; é que a próxima a ser encontrada nunca será corrigida. A migração é pequena: troque o import, passe tags como set (o nh3 rejeita uma lista com um TypeError, enquanto o bleach aceitava os dois), transforme cada lista de attributes em set, renomeie protocols para url_schemes, retire o strip=True (o Ammonia sempre remove) e substitua bleach e webencodings por nh3 no requirements.txt.
A sanitização é a correção; uma Content Security Policy é a rede de proteção para o dia em que ela falhar, seja por uma configuração errada, um caso limite da allowlist ou um vetor que ninguém previu. A diretiva que faz o trabalho contra XSS é a script-src, nunca com 'unsafe-inline': um <script>alert(1)</script> inline e um <script src="https://attacker.example/…"> de outra origem são recusados na hora da execução. Uma allowlist como 'self' continua confiando em tudo que a sua própria origem serve, como um arquivo enviado por usuário ou um endpoint JSONP, e é por isso que a OWASP recomenda nonces ou hashes, junto com object-src 'none' e base-uri 'none'. No Django, o middleware do django-csp adiciona o cabeçalho a partir de uma configuração CONTENT_SECURITY_POLICY. Uma CSP reduz a gravidade de um XSS que escapa; ela nunca fecha a brecha.
Ela também funciona como ferramenta de detecção. O Content-Security-Policy-Report-Only serve a mesma política, mas reporta as violações em vez de bloqueá-las: depois que você indica um endpoint com report-uri ou report-to, os navegadores compatíveis enviam um relatório JSON descrevendo o que a política teria recusado. Num site em produção, isso é o mais próximo de um sinal gratuito de detecção de intrusão para XSS. Ela pode revelar a injeção que passou pela sanitização, junto com os scripts legítimos que uma política restrita quebraria, e é a forma segura de testar uma política restrita antes de aplicá-la. Sua implantação, junto com o conjunto completo de diretivas e os nonces e hashes que liberam scripts inline legítimos, é assunto de um post posterior desta série.
A Visão do Analista
Um scanner entrega achados de XSS aos montes, e o vocabulário do CySA+ se paga na triagem, que é onde está a maior parte do trabalho real. A primeira pergunta não é "isso é explorável", e sim quem renderiza o valor armazenado — porque é isso que define o raio de alcance e, portanto, a prioridade. Um achado armazenado é um envio e vítimas ilimitadas, reexecutando a partir da sua própria origem a cada carregamento de página, então um campo que todo visitante vê passa à frente de um que só aparece para o usuário que o escreveu. A segunda pergunta é o que o payload de fato alcança: como o Django define HttpOnly no cookie de sessão por padrão, um relatório honesto diz que o atacante obtém acesso ao DOM e ações autenticadas na página — e não "sequestro de sessão" — a menos que a aplicação entregue um token que o JavaScript consiga ler.
Os controles se organizam com clareza quando você tem o vocabulário. A sanitização por allowlist antes do mark_safe() é um controle preventivo: ela elimina a construção perigosa em vez de ficar vigiando por ela. Uma Content Security Policy aplicada é uma segunda camada preventiva, não um substituto da primeira: ela restringe o que o navegador vai executar se a sanitização falhar, e é por isso que "nós temos CSP" nunca fecha um achado de XSS. Ela reduz a severidade; o achado continua aberto até o sanitizador ser corrigido. E, diferentemente das três camadas do Post 1, esta classe traz um controle detectivo de verdade: a CSP em modo report-only pode reportar o que tentou executar e foi recusado. Esse relatório é o mais próximo de um sinal de detecção de intrusão que a camada de aplicação oferece de graça.
Detectando Automaticamente
Testando Sua Defesa
Um único teste basta para provar a correção contra o payload armazenado: armazená-lo, renderizar o mural e conferir que nenhum event handler chega à página. Este é o que o laboratório usa:
PAYLOAD = "<img src=x onerror=\"alert(document.getElementById('session-token').textContent)\">"

def test_exploit_is_blocked_on_secure_view(self):
    html = self.client.get("/xss/secure/").content.decode()
    self.assertNotIn("onerror=", html)  # o nh3 remove o event handler, então nada é executado
O setUp grava o PAYLOAD como um comentário e um <strong> legítimo como outro. O cliente de teste não executa JavaScript, então o teste confere o markup que chega ao navegador, e não se o handler dispara; isso basta, porque um atributo onerror ativo já é a vulnerabilidade. Aponte o teste para /xss/vulnerable/ e ele falha. No seu projeto, faça a mesma verificação através do que quer que renderize conteúdo de usuário. Para um filtro de Markdown, acrescente o caso do link [clique aqui](javascript:alert(1)) e verifique que javascript: nunca chega à saída: isso passa com qualquer sanitizador com allowlist e falha com um mark_safe() sem sanitização. O tests.py do laboratório cobre as outras duas metades: o exploit funciona no mural vulnerável, e o mural seguro continua renderizando rich text legítimo.
Fazendo a Varredura
O SQL injection do Post 1 era uma classe que as ferramentas padrão pegam de forma limpa — o Bandit e o Semgrep sinalizaram a view vulnerável e ficaram quietos na segura. O XSS via mark_safe é onde esse resultado tão limpo desmorona — e ver como isso acontece é a lição.
O Bandit — o scanner que percorre a AST, do Post 1 — tem uma verificação mirada exatamente nesta classe: B703 / B308, uso de mark_safe. Aponte-o para as duas views do laboratório:
bandit -r labs/post_02_xss/
Ele dispara nas duas, com quatro achados no total — B308 e B703 em cada view. As duas entradas do B703:
>> Issue: [B703:django_mark_safe] Potential XSS on mark_safe function.
   Location: labs/post_02_xss/views_vulnerable.py:32:60
32    f"<li><strong>{escape(c.author)}</strong>: {as_html(mark_safe(c.body))}</li>"

>> Issue: [B703:django_mark_safe] Potential XSS on mark_safe function.
   Location: labs/post_02_xss/views_secure.py:28:60
28    f"<li><strong>{escape(c.author)}</strong>: {as_html(mark_safe(nh3.clean(c.body)))}</li>"
Nenhuma das duas consegue distingui-los. O B308 é uma entrada de blacklist baseada no nome da chamada, e o B703 lê o argumento, mas só considera seguros literais de string (e .format()/% sobre um literal) e nunca ouviu falar do nh3 — então mark_safe(c.body) (o bug) e mark_safe(nh3.clean(c.body)) (a correção) recebem achados idênticos. O achado na view segura é um falso positivo contra um código que já está correto.
As regras da comunidade do Semgrep não reportam nada, em nenhuma das views — mas não pela razão que você imaginaria:
semgrep scan --config p/django --config p/python --config p/owasp-top-ten labs/post_02_xss/
# Ran 156 rules on 15 files: 0 findings.
Não é que o Semgrep não tenha uma regra para isso. Ele tem uma — avoid-mark-safe — mas ela é marcada como subcategory: audit, confidence: LOW, e os pacotes curados que um analista de fato roda (p/django e afins) não a incluem; nenhuma das 156 regras que rodaram mira mark_safe. E invocar essa regra diretamente não salva o resultado. Ela ignora apenas literais de string e chamadas aninhadas dentro de format_html(...), então dispara em mark_safe(c.body) e em mark_safe(nh3.clean(c.body)) — ela nunca ouviu falar do nh3, então sinaliza a correção sanitizada assim como o Bandit.
Então nenhuma checagem pronta dá um resultado vulnerável-dispara / segura-silenciosa em que se apoiar: os pacotes não dizem nada, e as checagens de mark_safe que existem sinalizam a correção tão alto quanto o bug. Esse é o caso restrito em que uma pequena regra Semgrep customizada se justifica; na maior parte do tempo, as regras da comunidade bastam.
A regra é deliberadamente direta — na prática, é o avoid-mark-safe ensinado a reconhecer um sanitizador: sinalizar mark_safe() em qualquer coisa que não seja um literal de string nem uma chamada a um sanitizador/escapador de allowlist (nh3.clean, escape, ou format_html com uma string de formato literal, já que ele faz escape dos argumentos, mas nunca da própria string de formato):
# rules/xss.yaml  (resumida)
patterns:
  - pattern: mark_safe($X)
  - pattern-not: mark_safe("...")
  - pattern-not: mark_safe(nh3.clean(...))
  - pattern-not: mark_safe(escape(...))
  - pattern-not: mark_safe(format_html("...", ...))
Isso basta para separar as duas views — ela dispara na vulnerável e fica silenciosa na segura, o resultado limpo que nenhuma ferramenta padrão conseguiu dar:
semgrep --config rules/xss.yaml labs/post_02_xss/views_vulnerable.py   # 1 achado, linha 32
semgrep --config rules/xss.yaml labs/post_02_xss/views_secure.py       # 0 achados
Ela é honesta sobre os próprios limites. Por ser sintática e não rastrear taint, não enxerga a sanitização feita uma linha antes através de uma variável — clean = nh3.clean(x); mark_safe(clean) é um falso positivo que ela aceita, documentado no fixture de teste da regra. (O modo taint também pegaria isso, com uma fonte que você mesmo declara: uma regra cuja fonte é uma consulta ao manager do model, como $M.objects.$F(...), e cujo sanitizador é nh3.clean(...) dispara na view vulnerável e fica em silêncio na segura no motor open-source do Semgrep.) Ela também só casa com o nome mark_safe(...) escrito diretamente: safestring.mark_safe(x), um alias de import e SafeString(x) passam por ela, e ela nunca vê templates, então | safe e {% autoescape off %} ficam por conta do teste acima. No sentido oposto, from nh3 import clean e bleach.clean contam como não sanitizados. Um fixture de semgrep --test fixa o comportamento da regra, e a CI reexecuta tanto o fixture quanto a asserção nas duas views a cada commit.
As três execuções — Bandit, Semgrep da comunidade e a regra customizada — estão versionadas em scans/, para que você leia o que cada uma reportou sem instalar nada; o tests.py continua sendo a prova executável da vulnerabilidade em si.
Por que não há varredura dinâmica (DAST). O Post 1 pôde apontar o sqlmap para a aplicação no ar porque SQL injection é uma sonda de um parâmetro e uma requisição que uma ferramenta de linha de comando conduz de ponta a ponta. O XSS armazenado exige dois passos: enviar um payload e depois encontrá-lo renderizado numa resposta posterior, aqui um POST e um GET na mesma URL /xss/vulnerable/. Um scanner do tipo proxy como o OWASP ZAP pode receber essa requisição pronta, mas este laboratório não tem formulário HTML, de propósito (você publica com curl), então o crawler dele não tem nada para descobrir, e roteirizar o POST e o GET para ele repetiria o que o tests.py já faz. Um teste no navegador acrescentaria a única coisa que os testes não conseguem, ver o handler disparar; ele fica de fora porque o trio estático (Bandit, Semgrep da comunidade, a regra customizada) mais o tests.py executável já mostram tanto o bug quanto a sua correção.
O hábito que adquiri ao escrever este post: tratar todo mark_safe(), | safe e {% autoescape off %} que toca entrada do usuário como trabalho inacabado até que um sanitizador com allowlist tenha rodado antes dele. O Post 3 mergulha mais fundo no próprio mecanismo de templates: Server-Side Template Injection (SSTI), o que acontece quando a entrada do usuário chega diretamente ao renderizador de templates do Django, e por que o {{7*7}} do Jinja2 não é o único risco.
Leitura Complementar
- Django Docs — Escape automático de HTML
- Django Docs — Proteção contra cross-site scripting (XSS)
- nh3 — Bindings Python para o sanitizador Ammonia
- django-csp — Content Security Policy para Django
- MDN — Content Security Policy (CSP)
- OWASP A05:2025 — Injection
- OWASP XSS Prevention Cheat Sheet
- PortSwigger Web Security Academy — Cross-site scripting
- MITRE ATT&CK — T1059.007 JavaScript
- django-security-lab — o repositório complementar de laboratórios executáveis de vulnerabilidades Django
- A regra Semgrep customizada deste post —
rules/xss.yaml(com seu fixture de teste,rules/xss.py) - Web Security for Developers: Real Threats, Practical Defense (Malcolm McDonald) — Capítulo 7: Cross-Site Scripting Attacks
- Secure Web Application Development: A Hands-On Guide with Python and Django (Matthew Baker, Apress)
Próximo nesta série → Post 3: Server-Side Template Injection (SSTI): Quando os Templates do Django Viram Arma