Hashing Fraco de Senhas: Por Que uma Tabela SHA-1 Vazada Cai em Milissegundos
Django Security Series — Post 18 | Série IV: Falhas Criptográficas
OWASP A04:2025 — Cryptographic Failures | Tempo de leitura: ~18 min
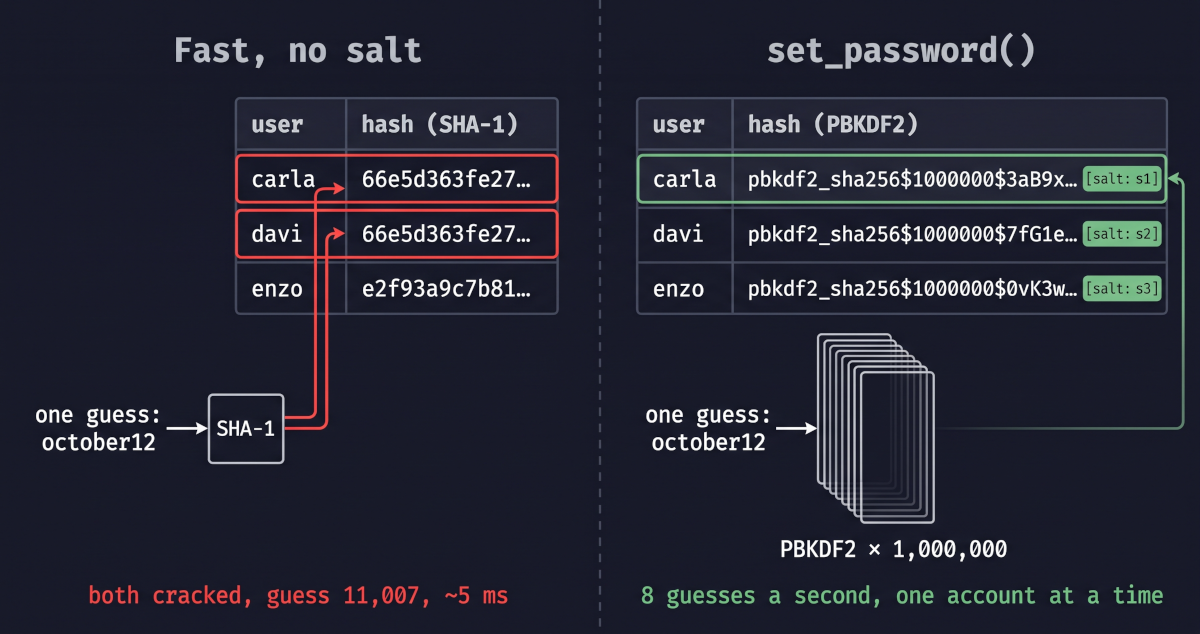
🧪 Rode você mesmo. Este ataque vem como um laboratório executável no django-security-lab, com uma tabela vazada e um cracker próprios. Extraia a tabela e as duas contas legadas caem numa passada de 11.007 chutes; cadastre a mesma senha pelo cadastro seguro e o mesmo cracker consegue cerca de oito chutes por segundo.
O Petição Brasil nunca definiu PASSWORD_HASHERS. O backend de login dele chama check_password(), a view de troca de senha chama set_password(), e entre os dois toda senha que ele guarda passa pelo padrão do Django: PBKDF2 com um salt aleatório e, no Django 5.2, um milhão de iterações. Ninguém escolheu isso. É o que se ganha por nunca mexer na configuração e nunca escrever uma coluna de senha à mão, e é esse o caso que vale a pena entender, porque os projetos que mexem nela raramente querem enfraquecer alguma coisa. Eles importam usuários de um sistema antigo, ou escrevem um modelo de usuário próprio, ou copiam uma configuração de testes para produção, e a tabela de senhas acaba protegida por algo que foi feito para ser rápido.
Um hash é a saída de uma função de mão única: a mesma senha sempre gera a mesma sequência curta e de tamanho fixo, e nada calcula a senha de volta a partir dela. É por isso que um site pode guardar o hash em vez da senha, calcular o hash do que for digitado no próximo login e comparar os dois. Um salt é um valor aleatório gerado para cada senha, guardado ao lado do hash dela e misturado à entrada antes do cálculo, de modo que duas pessoas com a mesma senha acabam com hashes diferentes. As iterações repetem o trabalho: o PBKDF2 repete seu passo interno, um HMAC-SHA256, um milhão de vezes para cada senha, então cada hash custa um milhão de rodadas em vez de uma.
Um hash de senha existe para um único dia: o dia em que a tabela vaza. Até lá, ele não faz nada que uma verificação de acesso não pudesse fazer. Este post acompanha o que um atacante faz com uma tabela vazada de hashes rápidos e sem salt.
O Ataque: O Que É e Como Funciona
Um servidor nunca precisa da sua senha de volta. Ele precisa conferir, no próximo login, que você digitou a mesma coisa de novo, então guarda o hash da senha e compara hashes. Isso funciona até alguém copiar a tabela, por uma injeção de SQL (Post 1), um backup esquecido num bucket ou as credenciais de VPN roubadas de um funcionário. Daí em diante o atacante tem todas as linhas, e o hash é a única coisa entre ele e as senhas.
Ele não consegue revertê-lo. Consegue chutar. Pega uma senha candidata, passa pela mesma função e compara o resultado com cada linha do dump. Nada na aplicação vê isso: não há formulário de login para limitar (Post 11), nem bloqueio, nem entrada de log. O ataque roda no hardware do atacante, offline, e os únicos limites são a velocidade da função e a qualidade dos chutes. Os chutes são muito bons. Listas de palavras ordenadas pela frequência com que pessoas reais escolheram cada senha, com regras de variação por cima, foram o assunto do Post 13. O arquivo mais conhecido é o rockyou.txt: as 14.344.392 senhas distintas do vazamento da RockYou em 2009, um site que as guardava em texto puro.
Duas propriedades do hash guardado decidem até onde isso vai.
A primeira é a velocidade. SHA-1, MD5 e SHA-256 puro foram projetados para serem rápidos, porque calculam o hash de arquivos e de tráfego de rede, e rápido é o que o atacante também quer. Um benchmark público do hashcat 6.2.6 numa única RTX 4090, uma placa de vídeo de consumo, calcula cerca de 50,6 bilhões de hashes SHA-1 por segundo. Nesse ritmo, calcular o hash do rockyou.txt inteiro é cerca de um terço de milissegundo de trabalho, e um conjunto de regras que transforma cada senha em cem variantes ainda fica em poucos centésimos de segundo. No meu laptop, Python puro num único núcleo fez 2,3 milhões de hashes SHA-1 por segundo, lento o bastante para se sentir e ainda suficiente para testar a lista inteira em cerca de seis segundos.
A segunda é o salt, que faz a mesma senha produzir um hash diferente em cada linha. Sem ele, a mesma senha produz o mesmo hash em todo lugar: em todas as linhas da sua tabela e em qualquer outro banco que tenha usado a mesma função. Isso dá ao atacante três presentes. Cada chute é calculado uma vez e conferido contra todas as linhas ao mesmo tempo, então atacar uma tabela de um milhão de linhas não exige mais cálculos de hash do que atacar uma só. Linhas que compartilham um hash compartilham uma senha, e o atacante descobre isso antes de quebrar qualquer coisa. E o trabalho pode ser feito com antecedência: tabelas pré-calculadas de hashes de senhas comuns transformam a quebra numa consulta.
Eis o ataque inteiro contra uma tabela assim. Suponha que uma tabela de contas legada guardava hashlib.sha1(password.encode()).hexdigest(), e que o dump tem três linhas, duas delas com 66e5d363fe272fbf3486695d2111921764d26e59. O atacante carrega o dump num dicionário indexado pelo hash e percorre uma lista de palavras uma vez, aqui as 19.640 senhas comuns que vêm dentro do Django para o CommonPasswordValidator (Post 13):
leaked = {}                                  # hash -> usuários
for username, digest in rows:
    leaked.setdefault(digest, []).append(username)

for line in gzip.open("common-passwords.txt.gz", "rt", encoding="utf-8"):
    guess = line.rstrip("\n")
    users = leaked.get(hashlib.sha1(guess.encode()).hexdigest())
    if users:
        print(guess, users)                  # october12 ['carla', 'davi']
october12 é o chute 11.007, e o SHA-1 dela é aquele hash: as duas contas caem no mesmo chute, depois de 11.007 cálculos de SHA-1, cerca de cinco milissegundos no ritmo do laptop acima. Uma senha do topo da lista, como 123456, cairia no primeiro chute por mais lento que fosse o hash; é o hash que decide o destino das senhas mais abaixo, como esta. O laço nunca pergunta qual conta está atacando, porque sem salt a pergunta não faz sentido. Toda senha que aparece em qualquer ponto da lista cai do mesmo jeito, e o que sobra são as senhas que a lista não contém, compartilhadas ou não.
O mesmo vazamento pode dar errado de outras formas também. Um hash com salt mas ainda rápido, como o MD5PasswordHasher do próprio Django, que a documentação de testes do Django sugere para acelerar uma suíte de testes, acaba com o trabalho compartilhado e com as tabelas pré-calculadas, mas não com a velocidade: cada conta custa uma passada separada pela lista de palavras, e cada passada ainda leva uma fração de segundo. Um hasher forte cujas iterações foram reduzidas para acelerar o login é rápido do mesmo jeito, só que menos. E um hash quebrado é só o começo: a senha recuperada funciona onde quer que o dono a tenha reutilizado, o que é credential stuffing (Post 11).
Incidentes Reais
LinkedIn — cerca de 6,5 milhões de hashes de senha SHA-1 sem salt publicados na internet (junho de 2012), e mais de 100 milhões do mesmo roubo em maio de 2016
Em 6 de junho de 2012, um arquivo com cerca de 6,5 milhões de hashes de senha SHA-1 apareceu na internet. O SANS Internet Storm Center os descreveu naquele mesmo dia como "unsalted SHA-1 password hashes". O LinkedIn confirmou no mesmo dia que "some of the passwords that were compromised correspond to LinkedIn accounts", invalidou essas senhas e mandou e-mail aos membros afetados. O comunicado acrescentava que os membros iriam "benefit from the enhanced security we just recently put in place, which includes hashing and salting of our current password databases": o salt chegou depois do roubo, não antes.
O arquivo mostra a falta de salt diretamente. Ele não trazia nomes de usuário, mas a Sophos contou cerca de 5,8 milhões de hashes únicos entre os 6,5 milhões, e num arquivo sem salt um hash que aparece duas vezes é a mesma senha duas vezes. Ao fim daquele dia, perto de 3,5 milhões dos hashes únicos, mais de 60 por cento, tinham sido quebrados e publicados em texto puro.
Os 6,5 milhões eram só parte do que foi levado. Em maio de 2016, um vendedor ofereceu um conjunto do mesmo roubo de 2012, que o LinkedIn descreveu como "email and hashed password combinations of more than 100 million LinkedIn members", e o LinkedIn invalidou essas senhas também. O roubo em si começou pelo computador de um funcionário: um júri dos EUA concluiu que Yevgeniy Nikulin instalou malware na máquina de um funcionário do LinkedIn, usou as credenciais desse funcionário para chegar à VPN corporativa e "stole a database containing LinkedIn users' login information, including encrypted passwords". Ele foi condenado em setembro de 2020 a 88 meses de prisão.
O MITRE ATT&CK classifica o que foi feito com o arquivo como T1110.002 — Brute Force: Password Cracking: recuperar senhas a partir de hashes que o atacante já tem, offline, longe da vista do serviço. Tudo o que veio depois do roubo aconteceu nas máquinas dos atacantes, e o LinkedIn só soube quanto tinha sido levado quatro anos depois.
Fontes: LinkedIn — An Update on LinkedIn Member Passwords Compromised (6 de junho de 2012) · SANS ISC — Potential leak of 6.5 million LinkedIn password hashes (6 de junho de 2012) · Computerworld — Hackers crack more than 60% of breached LinkedIn passwords (7 de junho de 2012) · LinkedIn — Protecting Our Members (18 de maio de 2016) · US Attorney's Office, N.D. California — Russian Hacker Sentenced To Over 7 Years In Prison (2020)
Proteções Padrão do Django
Os padrões do Django respondem às duas propriedades. PASSWORD_HASHERS começa com o PBKDF2PasswordHasher, que executa um milhão de iterações de HMAC-SHA256 no Django 5.2, um número que cada versão aumenta. Cada senha recebe o próprio salt, de 22 caracteres aleatórios, 128 bits, e o valor guardado registra tudo o que é preciso para conferi-la depois:
pbkdf2_sha256$1000000$OQoN8WBrBVsb9CBHW5L5kO$Nd/2PizkFBFfG0ZeGuHnmZCpDKdSn7gHC7BavHvwaH0=
Algoritmo, iterações, salt, hash. Calcule o hash da mesma senha de novo e o salt, e com ele o hash, sai diferente. O custo acompanha. O mesmo benchmark que faz 50,6 bilhões de hashes SHA-1 por segundo faz cerca de 8,9 milhões de hashes PBKDF2-SHA256 por segundo com 999 iterações, o que com um milhão de iterações dá cerca de 8.900, um pouco menos de seis milhões de vezes mais lento que o SHA-1. No meu laptop, um hash levou 0,31 segundo. Pela mesma estimativa, a lista do rockyou que era um terço de milissegundo de trabalho em SHA-1 passa a cerca de 27 minutos na mesma placa, e isso para uma conta: com um salt em cada linha, a conta seguinte começa do zero.
set_password() e check_password() são a interface inteira. O set_password() calcula o hash com o primeiro hasher da lista. O check_password() lê o algoritmo no valor guardado, então um projeto pode manter hashes de vários hashers ao mesmo tempo, e, quando uma senha correta está guardada sob qualquer hasher que não seja o primeiro, ou com menos iterações do que o padrão atual, ele calcula o hash da senha de novo com o atual e salva. É assim que uma tabela se atualiza sozinha conforme os usuários entram, e é assim que os aumentos anuais de iterações do Django chegam aos hashes antigos.
Os padrões param na fronteira desses dois métodos. PASSWORD_HASHERS é seu para substituir, e o Django distribui o MD5PasswordHasher no mesmo módulo para quem pedir. E uma string escrita direto no campo password não é conferida contra nada: entregue ao check_password() um digest hexadecimal puro de 40 caracteres e ele não consegue identificar um hasher, então roda um hash falso para manter o tempo de resposta igual e retorna False. Um projeto que calcula os hashes das senhas por conta própria, portanto, não consegue usar o login do Django. Ele precisa escrever a própria comparação também, e é por isso que esse erro anda junto com um backend de autenticação próprio.
O Padrão Vulnerável e a Correção
Padrão 1 — Uma coluna de senha com hash calculado à mão
A origem costuma ser uma migração de um sistema antigo. O banco antigo guardava cada senha como um digest hexadecimal SHA-1: 40 caracteres, sem salt, sem iterações. O novo projeto Django copia esses valores para User.password sem alteração e esbarra no problema da seção anterior: o login do Django não consegue conferi-los. Então alguém escreve um backend de autenticação que faz o que o sistema antigo fazia, calculando o SHA-1 da senha digitada e comparando, e o adiciona a AUTHENTICATION_BACKENDS. Daí é um passo curto para guardar os novos cadastros do mesmo jeito, para que um único backend confira todas as contas. O Django não exige isso, já que o ModelBackend poderia continuar na lista e conferir as linhas que o set_password() escreve, mas um formato só na tabela parece mais simples, e um atalho tomado para importar contas antigas vira a forma como toda senha nova é guardada.
A correção tem duas metades. A primeira é a view de cadastro, que escreve o digest direto no campo:
 def register(request):
     ...
     user = User(username=username, email=email)
-    user.password = hashlib.sha1(password.encode()).hexdigest()
+    user.set_password(password)
     user.save()
O set_password() não recebe um hash. Ele recebe a senha e monta o valor guardado inteiro, mostrado na seção anterior: pega o primeiro hasher de PASSWORD_HASHERS, gera um salt aleatório novo, aplica o número de iterações atual e escreve algoritmo, iterações, salt e hash no campo. Toda linha nova fica com salt e lenta, e duas pessoas com a mesma senha deixam de compartilhar um valor.
A segunda metade é o backend, que recalcula o SHA-1 do que foi digitado e o compara com o digest guardado:
-class SHA1Backend(ModelBackend):
-    def authenticate(self, request, username=None, password=None, **kwargs):
-        user = User.objects.filter(username=username).first()
-        if user and user.password == hashlib.sha1(password.encode()).hexdigest():
-            return user
As linhas escritas pelo set_password() não precisam dele. O próprio ModelBackend do Django chama o check_password(), que lê de volta o algoritmo, as iterações e o salt do valor guardado, calcula o hash da senha digitada com eles e compara os resultados. Mas o backend não pode ser apagado no dia em que o cadastro é corrigido. As linhas importadas ainda são digests SHA-1 puros, o check_password() retorna False para todas elas, e sem o backend todo mundo que se cadastrou antes da correção fica trancado do lado de fora. Ele sai, junto com a entrada dele em AUTHENTICATION_BACKENDS, quando essas linhas tiverem sido convertidas, que é o Padrão 2.
Padrão 2 — As linhas que já estão na tabela
Corrigir os novos cadastros deixa cada linha importada como estava: um SHA-1 rápido e sem salt. O backend poderia recalcular cada uma com o set_password() no próximo login do dono, mas uma tabela guarda muitas contas cujos donos nunca vão entrar, e essas linhas continuam tão quebráveis quanto no dia em que foram importadas. A documentação do Django descreve a correção exatamente para isso, com o MD5 como exemplo: um hasher "embrulhado", o PBKDF2 rodando sobre o digest antigo, de modo que todas as linhas podem ser convertidas numa única data migration sem conhecer uma única senha. Para o SHA-1:
class PBKDF2WrappedSHA1PasswordHasher(PBKDF2PasswordHasher):
    algorithm = "pbkdf2_wrapped_sha1"

    def encode_sha1_hash(self, sha1_hash, salt, iterations=None):
        return super().encode(sha1_hash, salt, iterations)

    def encode(self, password, salt, iterations=None):
        sha1_hash = hashlib.sha1(password.encode()).hexdigest()
        return self.encode_sha1_hash(sha1_hash, salt, iterations)
A migration substitui cada digest de 40 caracteres por hasher.encode_sha1_hash(digest, hasher.salt()), e o hasher entra em PASSWORD_HASHERS depois do padrão, para que o próprio login do Django consiga conferir essas linhas e o backend de SHA-1 possa enfim ser removido. Uma linha embrulhada agora tem salt e é lenta: chutá-la significa rodar o PBKDF2 para cada candidata. No próximo login correto do dono, o check_password() vê um hasher diferente do primeiro e recalcula o hash da senha com o PBKDF2 puro.
Embrulhar protege a tabela do próximo vazamento. Não faz nada por uma tabela que já vazou: aqueles digests SHA-1 estão nas mãos de outra pessoa, tão rápidos e sem salt quanto eram, então, depois de um vazamento conhecido, as próprias senhas precisam ser redefinidas.
A Visão do Analista
O ponto do CySA+ aqui é sobre indicadores, e sobre uma etapa de ataque que não tem nenhum. A quebra de senhas (T1110.002) é o único passo de um ataque a credenciais que não deixa nada do lado da vítima: nenhum login falho, nenhum bloqueio, nenhuma requisição. Os indicadores ficam antes e depois dela. Antes vem a exfiltração: uma exportação do banco, um volume incomum de linhas saindo por uma consulta, um backup copiado para fora do bucket, os rastros que uma injeção de SQL (Post 1) ou uma intrusão como a do LinkedIn deixam se alguém estiver olhando. Depois vêm as próprias senhas quebradas, voltando como logins bem-sucedidos de lugares desconhecidos e como credential stuffing contra o seu formulário de login e o de todo mundo (Post 11). O analista que espera a quebra aparecer nos logs acaba vendo o stuffing no lugar dela.
Isso faz do formato guardado uma entrada da resposta a incidentes, e não só do desenvolvimento. Quando o vazamento de uma tabela é confirmado, o escopo começa pelo custo de quebrar os hashes dela. Trate digests rápidos e sem salt como texto puro a partir do momento do vazamento, mesmo que as senhas que nenhuma lista contém sobrevivam: invalide todas as senhas, encerre todas as sessões e assuma que cada senha já está sendo testada em outro lugar. Hashes lentos e com salt compram tempo e mudam a ordem do trabalho. As senhas fracas continuam caindo, muitas vezes entre os primeiros chutes, então as redefinições continuam necessárias. A conta em Proteções Padrão do Django diz quanto custa cada chute, não quanto tempo uma senha dura, e não é um prazo de carência. O LinkedIn invalidou as senhas do arquivo de 2012; mais de 100 milhões do mesmo roubo apareceram quatro anos depois, e essas também tiveram de ser invalidadas.
Detectando Automaticamente
Testando Sua Defesa
O teste que importa cadastra a mesma senha duas vezes pelo cadastro seguro e lê o que foi guardado:
def test_secure_register_stores_salted_pbkdf2_and_logs_in_through_django(self):
    for name in ("elisa", "fabio"):
        resp = Client().post(SECURE_REGISTER, {"username": name, "password": LEGACY_PASSWORD})
        self.assertEqual(resp.status_code, 201)
    elisa, fabio = self.password_of("elisa"), self.password_of("fabio")
    algorithm, iterations, salt, _ = elisa.split("$")
    self.assertEqual((algorithm, iterations, len(salt)), ("pbkdf2_sha256", "1000000", 22))
    # Same password, different rows: nothing shared, nothing precomputable.
    self.assertNotEqual(elisa.split("$")[2], fabio.split("$")[2])
    self.assertNotEqual(elisa, fabio)

    client, resp = self.log_in(SECURE_LOGIN, "elisa", LEGACY_PASSWORD)
    self.assertContains(resp, "logged in as elisa")
    self.assertContains(client.get(NOTE), "elisa's notes")
Faça o cadastro voltar a escrever hashlib.sha1(...) e ele quebra, porque o valor guardado não tem $ para dividir. O tests.py do laboratório tem o resto: a tabela vazada quebrada numa passada, uma linha do set_password() não alcançada em um segundo de chutes, o embrulho convertendo todas as linhas legadas sem uma senha, um login correto atualizando uma linha embrulhada para pbkdf2_sha256, e o vazamento antigo ainda sendo quebrado depois do embrulho.
No seu próprio projeto, a verificação vale para os dados além do código, porque linhas importadas nunca passam pela sua view de cadastro. No manage.py shell:
User.objects.exclude(password__contains="$").exclude(password__startswith="!").count()
Todo valor que os hashers do Django escrevem separa suas partes com $, e uma senha inutilizável, definida por set_unusable_password(), começa com !. Qualquer outra coisa na coluna foi escrita à mão, por uma view, um script de importação ou um UPDATE em SQL puro, e o login do Django não consegue conferi-la. A resposta deve ser 0, antes e depois de qualquer importação. Um zero diz que toda linha nomeia um hasher, não que o hasher seja bom: uma linha md5$… passa, e é para isso que serve a busca nas configurações em Fazendo a Varredura.
Fazendo a Varredura
As duas ferramentas padrão marcam a linha vulnerável, e nenhuma delas está marcando o bug. O Bandit e os pacotes curados do Semgrep, rodados contra o laboratório:
bandit -r labs/post_18_password_hashing/
# 9 problemas: B324 nas 7 chamadas a hashlib.sha1, B105 x2
semgrep scan --config p/django --config p/python --config p/owasp-top-ten labs/post_18_password_hashing/
# Ran 156 rules on 21 files: 8 findings.
O B324 do Bandit e o insecure-hash-algorithm-sha1 do Semgrep disparam na linha 45 de views_vulnerable.py, user.password = hashlib.sha1(password.encode()).hexdigest(), e não dizem nada sobre o set_password(). Até aqui, é a separação que se espera de um scanner. Mas eles disparam também em todas as outras chamadas a hashlib.sha1 do módulo: o cracker do atacante, o seed, um teste e o hasher embrulhado do Padrão 2, que é a correção e precisa calcular SHA-1 para chegar aos digests antigos. As duas verificações são listas de nomes de algoritmos. O B324 reporta md5 e sha1, a menos que a chamada passe usedforsecurity=False (documentação do Bandit). A regra do Semgrep é o padrão único hashlib.sha1(...); a mensagem dela fala de resistência a colisões, e o autofix troca sha1 por sha256 (a regra). Resistência a colisões é o que uma assinatura precisa. Guardar senhas precisa de uma função lenta, e o ASVS 5.0 lista as duas coisas como requisitos separados, V11.4.3 e V11.4.2 (ASVS 5.0, V11).
A consequência é fácil de conferir. Edite a linha 45 para usar sha256, sha3_256 ou blake2b, todos tão rápidos e tão sem salt quanto o SHA-1, e nenhuma das ferramentas reporta nada nessa linha, nem nos pacotes curados do Semgrep nem na camada de registry; o que sobra são os achados de CSRF e de HTML inline que o original também recebe. Acrescente usedforsecurity=False, como sugere a mensagem do B324, e o Bandit também se cala. O próprio autofix da regra do Semgrep produz uma linha que é quebrada do mesmo jeito e que nenhum scanner aqui marca; as execuções estão em scans/fast-hash-variants.txt, no laboratório. Enquanto isso, o achado mais grave dos pacotes curados, use-none-for-password-default em ERROR, cai na view segura: ele marca request.POST.get("password", "") chegando ao set_password(), embora duas linhas depois a view recuse uma senha vazia com um 400. Uma busca nas definições de regras das cinco configs do Semgrep não encontra nenhuma regra que mencione .password =, make_password, PASSWORD_HASHERS ou uma classe de hasher, e as três que mencionam set_password() examinam a correção.
Por isso o laboratório traz uma regra própria, rules/password_hashing.yaml. É uma regra de taint. As fontes são as funções de digest do hashlib, qualquer algoritmo, e o hmac; os sinks são uma atribuição a .password, um argumento password= no construtor de um modelo, em create() ou em update(), e uma comparação com .password; e o make_password() e o encode() de um hasher, reconhecido pelo nome, limpam o taint.
semgrep scan --config rules/password_hashing.yaml labs/post_18_password_hashing/views_vulnerable.py
# Ran 1 rule on 1 file: 1 finding.
semgrep scan --config rules/password_hashing.yaml labs/post_18_password_hashing/views_secure.py
# Ran 1 rule on 1 file: 0 findings.
Ela dispara na linha 45 seja qual for o algoritmo, e na comparação do SHA1Backend; fica em silêncio na view segura e no hasher embrulhado, e o CI do repositório confere essa divisão. A fixture dela registra seus limites. Ela não pega um campo com outro nome, como password_hash, um UPDATE em SQL puro, um esquema rápido de uma biblioteca como a passlib, nem pbkdf2_hmac() com uma única iteração. Ela marca um campo chamado password que guarda o digest de uma chave de API aleatória, caso em que um hash rápido basta. E ela não enxerga as outras formas de um projeto enfraquecer o hashing, MD5PasswordHasher em primeiro em PASSWORD_HASHERS ou um hasher com iterações reduzidas, porque isso é configuração, não fluxo de dados:
grep -rnE "PASSWORD_HASHERS|MD5PasswordHasher|iterations\s*=" --include=*.py .
Um resultado nas configurações de teste é o que a documentação de testes do Django recomenda. A mesma linha nas configurações de produção é a vulnerabilidade.
O hábito a levar deste post é ler a coluna de senhas, e não só o código que escreve nela. Todo valor deve dizer qual é o seu hasher, e uma linha que não diz foi escrita por algo que o Django nunca viu. Quando uma tabela recebeu hash rápido, embrulhar a protege do próximo vazamento, e só uma redefinição ajuda depois do último. O Post 19 passa do que o servidor guarda para o que ele envia: os atributos de cookie que mantêm um cookie de sessão fora do HTTP puro e fora do alcance do JavaScript.
Leitura Complementar
- django-security-lab —
labs/post_18_password_hashing/— o laboratório executável: um cadastro que guarda SHA-1 e outro que chamaset_password(), um comando de vazamento, um cracker só com a biblioteca padrão, a migration de embrulho e a saída capturada dos scanners emscans/ -
django-security-lab —
rules/password_hashing.yaml— a regra customizada do Semgrep e, ao lado dela, a sua fixture -
Documentação do Django — Password management in Django —
PASSWORD_HASHERS, a atualização no login e a receita do hasher embrulhado para linhas MD5 legadas - OWASP Password Storage Cheat Sheet
- OWASP A04:2025 — Cryptographic Failures
- OWASP ASVS 5.0 — V11 Cryptography — V11.4.2, armazenamento de senhas
- MITRE ATT&CK — T1110.002: Password Cracking